- 发布于
GPU 基础
AI 辅助翻译自英文阅读英文原文
- 作者

- 姓名
- Garfield Zhu
- @_AlohaYo_
@Author: Garfield Zhu
认识 GPU
让我们从真实硬件开始理解 GPU。
(当然也有 AMD!但本文只展示 Nvidia 的示例。🤣🤣🤣)
架构
让我们拆解一块 GTX 4080 GPU,看看里面有什么。
GTX 4080 - 完整显卡

其他 OEM:


GTX 4080 - 电路板部分

打开面板

PCB 面板

ROG Strix PCB:

聚焦核心

其他视图:
其他显卡

拉近视图


低端显卡

现在聚焦核心芯片(Nvidia):
爆炸图(Tesla V100)

抽象视图

Fermi - 带 SM(流式多处理器)

由 CUDA 核心组成的流式多处理器

Kepler - 展开 SM

Pascal - 更多 SM

Volta - Tensor 核心


Ampere - RT 核心


⚖️ 与 CPU 比较
CPU 适合多种工作负载,尤其适合重视延迟或单核性能的任务。作为强大的执行引擎,CPU 将较少的核心集中于单个任务并快速完成,因此从串行计算到运行数据库都非常擅长。
GPU 最初是用于加速特定 3D 渲染任务的专用 ASIC。随着时间推移,这些固定功能引擎变得更可编程、更灵活。尽管图形和当今顶级游戏日益逼真的画面仍是其主要用途,GPU 也已演变为更通用的并行处理器,能够处理越来越多的应用。
| CPU | GPU |
|---|---|
| 通用计算 | 专用计算 |
| 任务并行 | 数据并行 |
| 少量高性能核心 | 大量轻量级核心 |
| 大容量内存 | 高内存吞吐量 |
| 多样的指令集 | 少量高度优化的指令集 |
| 显式线程管理 | 由硬件管理线程 |

示例
CPU 就像只有一个或几个工匠的车间。他们技艺精湛,只要给出蓝图和足够时间,什么都能完成。
GPU 就像有许多工人的流水线。他们受教育程度不高,但能并行完成相同工作。给出简单明确的指令后,他们能非常快速地完成任务。
🔖 阅读 GPU 规格
为了更好地理解 GPU 的性能,我们需要学会阅读其核心指标规格。
我们可以在第三方网站查看 GPU 的集中参数规格:https://www.techpowerup.com/gpu-specs/
也可以查看 GPU 制造商(Nvidia、AMD 和 Intel)的官方网站,例如:
核心
与 CPU 类似,GPU 也有核心,用于并行计算。 CPU 最多约 48 个核心,而 GPU 最多可达 10,000 个核心。
| Chip | Cores | Clock |
|---|---|---|
| Intel Core i9-13900K | 24 | 5.8 GHz (Turbo) |
| AMD Ryzen 9 7950X3D | 16 | 5.7 GHz (Boost) |
| AMD 7900XTX | 6144 | 2.5 GHz (Boost) |
| RTX 4070Ti | 7680 | 2.61 GHz (Boost) |
| RTX 4090 | 16384 | 2.52 GHz (Boost) |
| Tesla H100 | 14592 | 1.845 GHz (Boost) |
CUDA 核心(Nvidia)
通常,GPU 核心是渲染管线中的着色单元;但 Nvidia 将其称为 CUDA Cores,强调核心的并行计算能力。
- 它们高度并行,可以同时处理多个任务。
- 它们拥有高内存带宽,能够快速访问大量数据。
- 它们专为可并行化的算法设计。
CUDA(Compute Unified Device Architecture,统一计算设备架构)是 GPGPU 的正式名称。如今它既是 Nvidia GPU 核心的称呼,也是 GPGPU 领域最流行的 API。
Tensor 核心(Nvidia)
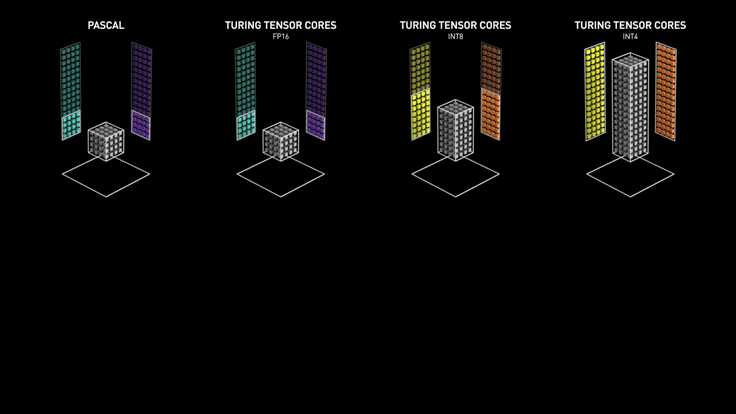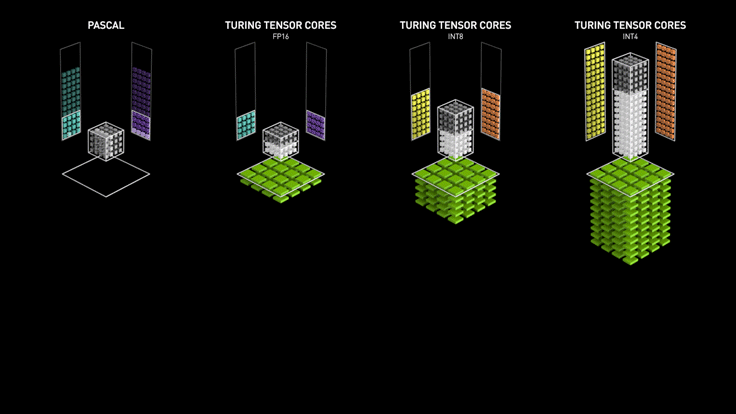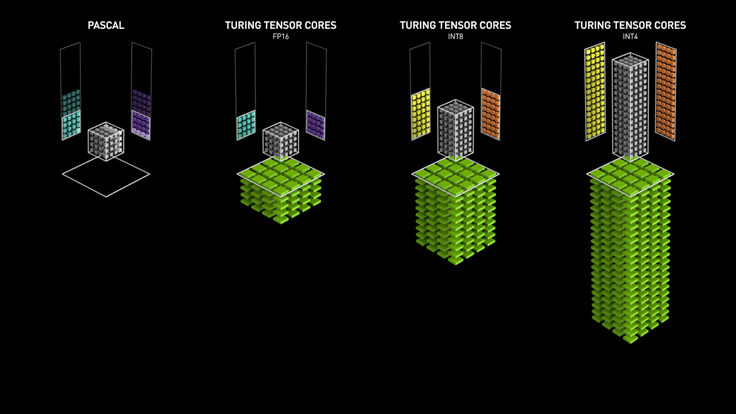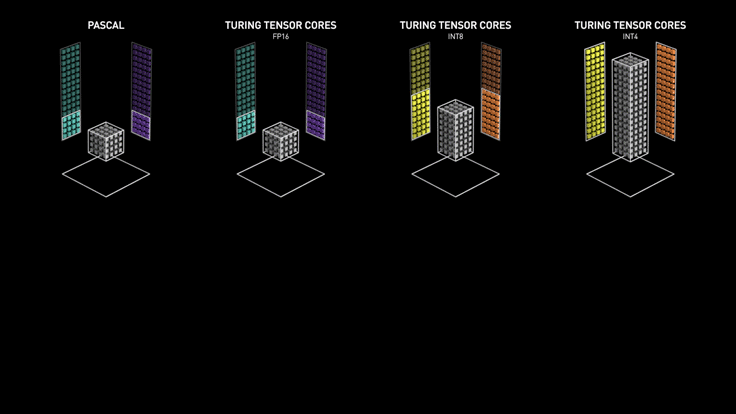
Tensor 核心本质上是用于加速矩阵乘法的处理单元。
随着矩阵(张量)的大小和维度增加,计算复杂度会成倍上升。机器学习、深度学习和光线追踪都涉及大量乘法运算。

Ampere - Tensor 核心
RT 核心
它被称为“光线追踪核心”,是光线追踪技术的硬件实现。
光线追踪计算是一种与光线相关向量计算的特定渲染模式,参见光线追踪笔记。

简而言之,RT 核心为通用 CUDA 核心增加额外电路,在进行光线追踪计算时可纳入渲染管线。
光线追踪演示:NVIDIA Marbles at Night | RTX Demo
总线、时钟与内存
总线、时钟与内存规格


总线
总线连接 GPU 与主板,是 GPU 与 CPU 之间的数据高速公路。
总线类型:PCIe 4.0、PCIe 5.0 等。
参见 PCIe 4.0 与 5.0 对比总线通道:x16、x8、x4 等。
总线宽度:128 位、192 位、256 位、384 位等。
时钟速度
时钟速度就是 GPU 的运行速度(单位:MHz)。
和 CPU 一样,它包含核心时钟速度与内存时钟速度。
内存
GPU 的内存称为 VRAM(Video RAM,显存)。
内存类型与容量
- 类型:GDDR5、GDDR6、GDDR6X 等。
- 容量:如今主流容量为 8GB、12GB、16GB、24GB 等。
和 RAM 一样,容量越大越好。🤣
更大的显存可以支持:- [图形] 更高质量的纹理(4K、8K 等)
- [图形] 更复杂的几何体(更高的多边形数量、细分曲面等)
- [深度学习] 更大的数据集和批次
- [深度学习] 更复杂、更大的模型
内存总线宽度与带宽
- 总线宽度:也称
Bit Width或Memory Interface Width,表示可以同时传输的位数。 - 带宽:内存总线的总体传输能力,是总线宽度与时钟频率及架构倍率的乘积。
- 公式:
Bandwidth = Bus Width * Clock Frequency * Architecture Multiplier - 单位:GB/s,例如 320 GB/s
- 公式:
- 总线宽度:也称
着色器、TMU 与 ROP
对于渲染管线:
GPU 着色单元负责在 GPU 上执行着色器程序,是 GPU 的常规核心。
TMU 是 Texture Mapping Unit(纹理映射单元)的缩写,负责将纹理映射到多边形。
ROP 是 Render Output Unit(渲染输出单元)的缩写,负责将最终像素数据写入帧缓冲区。
TFLOPS(万亿次浮点运算)
TFLOPS(teraFLOPS)是 tera(10^12)FLoating point Operations Per Second(每秒万亿次浮点运算)。
通常指 32 位浮点数。
GFLOPS 顾名思义是 giga(10^9)FLOPS。过去常用 GFLOPS,如今已进入 TFLOPS 时代。
跨平台图形核心的 TFLOPS 之战:
| 平台 | TFLOPS |
|---|---|
| PS5 | 10.28 |
| XBOX Series X | 12.00 |
| Nintendo Switch | 0.4 / 0.5 (Docked) |
| Apple A17 Pro | 2.15 |
| Apple M2 Ultra (76 core) | 27.2 |
| Intel UHD Graphics 770 | 0.794 |
| Intel Iris Xe Graphics G7 96RUs | 1.690 |
| Intel Arc A770 | 19.66 |
| AMD Radeon RX 7800 XT | 37.32 |
| AMD Radeon RX 7900 XTX | 61.42 |
| GeForce RTX 2080 Ti | 13.45 |
| GeForce RTX 3090 | 35.58 |
| GeForce RTX 4070 Ti | 40.09 |
| GeForce RTX 4090 | 82.58 |
| Tesla H100 | 67 |
示例
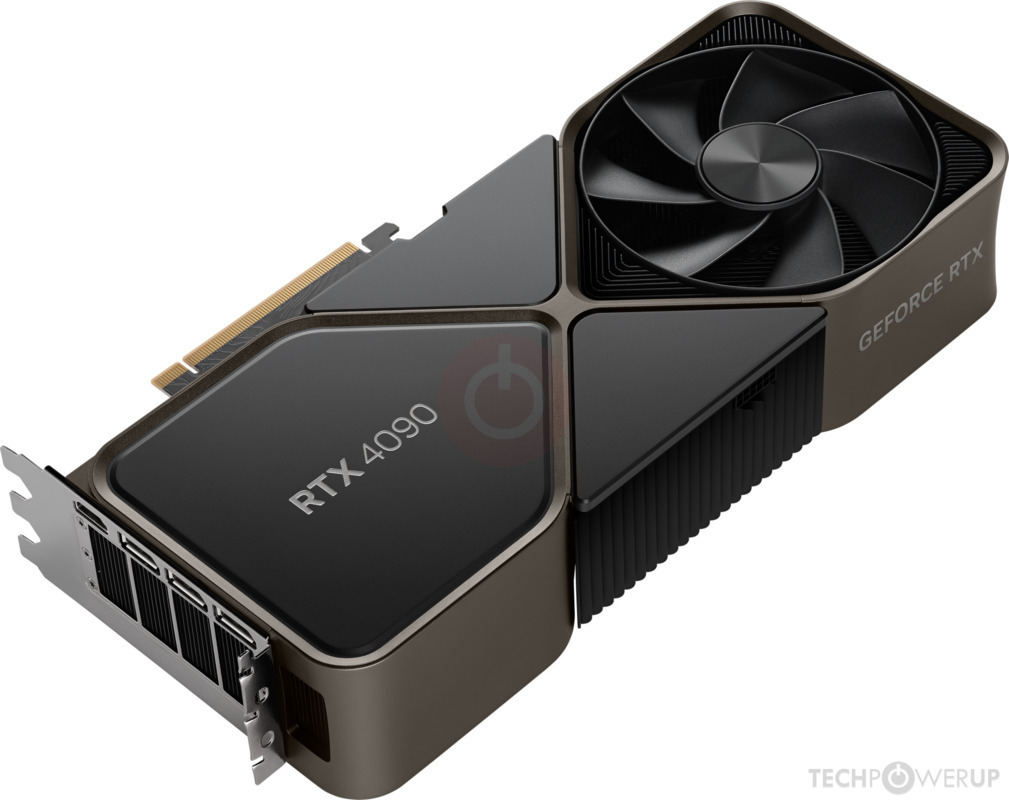
现在来阅读 RTX 4090 的规格:
GPU 如何运行
CPU 运行代码

传统 GPU 运行代码

GPGPU(通用 GPU)
在通用 GPU 架构中,Nvidia 利用 CUDA 核心(通常每组 128 个)构建 SM(流式多处理器)来运行代码。

GTX 980(2014 - Maxwell)


使用 GPU 编程
OpenGL 与 GLSL
OpenGL(Open Graphics Library)是用于渲染 2D 和 3D 矢量图形的跨语言、跨平台 API。
GLSL(OpenGL Shading Language)是基于 C 语言的高级着色语言。
WebGL 与 WebGPU
WebGL(Web Graphics Library)是 JavaScript API,可在兼容的 Web 浏览器中无需插件渲染交互式 2D 和 3D 图形。
CUDA
CUDA 是 Nvidia 开发的并行计算平台和编程模型,用于在其 GPU(图形处理器)上进行通用计算。
与 OpenGL 不同,CUDA 是通用并行计算平台和编程模型。OpenGL 专注于图形渲染,而 CUDA 用于并行计算(例如深度学习、加密货币挖矿)。

C 示例:
// CUDA C
__global__ void myKernel() {
  printf("Hello world\n");
}

int main(int argc, char const *argv[]) {
    myKernel<<<4,2>>>();
    return 0;
}
Python 示例:
# CUDA Python by numba

from numba import cuda

def cpu_print(N):
    for i in range(0, N):
        print(i)

@cuda.jit
def gpu_print(N):
    idx = cuda.threadIdx.x + cuda.blockIdx.x * cuda.blockDim.x
    if (idx < N):
        print(idx)

def main():
    print("gpu print:")
    gpu_print[2, 4](8)
    cuda.synchronize()
    print("cpu print:")
    cpu_print(8)

if __name__ == "__main__":
    main()